
Em duas semanas, a marca d'água da inteligência artificial saiu do nada para virar assunto de vídeo viral, de post de advogado e de repositório com vinte mil estrelas no GitHub. Quase tudo que se diz sobre ela está errado, inclusive nos materiais mais bem produzidos. Este texto é o que sobrou depois que eu abri o código, li a documentação e conferi a lei — afirmação por afirmação.
O que mudou em 2 de agosto
Os modelos do Claude lançados a partir de 2 de agosto de 2026 embutem uma marca imperceptível no texto que geram. A Anthropic publicou o funcionamento em How Claude's text watermark works, e a central de ajuda descreve o escopo: vale em todo lugar onde você usa o Claude — aplicativo, API, Claude Code, Cowork —, inclusive quando o modelo é servido por AWS, Google Cloud ou Microsoft Foundry.
Não existe opção de desligar. A tecnologia tem nome e sobrenome: é uma implementação do SynthID-Text, do Google DeepMind, adotada pela Anthropic.
A razão é regulatória, e aqui já começa a primeira imprecisão que circula. Diz-se que o artigo 50 do regulamento europeu de inteligência artificial obriga a marca d'água. Ele não obriga. O artigo 50(2) exige que o conteúdo sintético seja marcado em formato legível por máquina, e as diretrizes oficiais da Comissão admitem expressamente metadados, proveniência criptográfica, logging e fingerprints.
Quem exige marca d'água em texto é outro instrumento: o Código de Conduta sobre Transparência de Conteúdo Gerado por IA, na Sub-measure 1.1.2. E ele explica por que o texto é caso à parte, com uma frase que resolve a confusão inteira: free-form text cannot transport metadata. Texto puro não carrega metadado. Sobra a marca.
O mesmo documento fixa um piso que quase ninguém cita: a marcação é exigida para texto livre acima de 200 tokens. Abaixo disso, o próprio código reconhece que não há sinal confiável.
Onde a marca mora, e por que quase todo mundo explica errado
A explicação que virou padrão é a do dado viciado: o modelo passaria a preferir certas palavras. É intuitiva, é fácil de desenhar num slide, e não é o que acontece.
O Claude escreve uma palavra por vez. Em muitos pontos, várias palavras servem igual — "o pedido foi acolhido", "provido", "deferido", "julgado procedente" — e nesses pontos a escolha se resolve por um número aleatório. O que a marcação faz é trocar de onde vem esse número: em vez do gerador comum, ele sai de uma chave secreta combinada com o texto que veio antes.
A própria Anthropic é explícita: as escolhas continuam sendo feitas ao acaso, e o que muda é a fonte desse acaso. A distribuição se preserva. Quem tem a chave refaz o mesmo sorteio depois e verifica se bateu.
Isso explica três coisas de uma vez. Por que copiar e colar não tira nada — você está levando as palavras, e a marca são elas. Por que trocar meia dúzia de sinônimos não resolve — o sinal está espalhado por milhares de escolhas. E por que o texto não fica pior — nenhuma palavra isolada foi degradada.
A ferramenta que estourou no GitHub
O repositório guillaumemeyer/watermarks-remover foi criado em 11 de agosto de 2026 e passa de vinte mil estrelas. É uma skill de agente com um serviço em Python, licença MIT, código aberto para qualquer um ler. Não é golpe, e a documentação é honesta — mais honesta, aliás, que boa parte de quem a divulga.
Ela trabalha em três camadas. Duas funcionam:
- Caractere invisível no texto — espaços exóticos, marcas de direção, caracteres de tag. Script determinístico: roda e some.
- Metadados de arquivo — C2PA, EXIF, XMP, propriedades de documento, em PNG, JPEG, PDF, DOCX, XLSX, EPUB e mais. Limpa de verdade.
A terceira é a que interessa, e é onde o manual muda de tom. Para a marca estatística, a ferramenta declara best-effort — melhor esforço. O que ela faz é mandar outro modelo reescrever o texto inteiro.
E há uma armadilha prática que ninguém conta. Em arquivos — Markdown, HTML, PDF, DOCX — a reescrita não roda. Está escrito no manual: containers são limpos como containers, com metadado e camada A, e não passam pela camada B. Se você jogar a sua petição em .docx na ferramenta, ela limpa o metadado, devolve o arquivo, e a marca continua inteira. A reescrita só acontece com texto puro, colado.
A linha que ninguém leu
Para saber se apagou, a ferramenta precisaria de um detector. E o detector do Claude, dentro dela, ainda não existe. Na matriz de capacidades, a linha correspondente traz um espaço reservado e uma nota: a Anthropic anunciou uma API de detecção, e essa costura ativa quando ela sair.
Ou seja: a ferramenta reescreve o seu texto de ponta a ponta e não tem como conferir o resultado. O manual admite isso em uma frase que devia estar em todo material sobre o assunto — enquanto os fornecedores não publicarem detectores e chaves, nenhuma ferramenta pode honestamente certificar que um texto falha na checagem oficial.
Há um segundo achado na mesma matriz, e é notícia: o Google aposentou o detector oficial do SynthID para texto na API, em agosto de 2026. O Gemini continua marcando; o que sumiu foi a ferramenta de verificar.
Vale registrar também a cláusula de ética do projeto, porque ela desarma o enquadramento fácil. O manual diz que a ferramenta é destinada ao conteúdo que é seu, por privacidade e higiene, e que os resultados não devem ser apresentados como prova de autoria humana.
A skill que promete humanizar
A saída que mais aparece nos comentários é mandar a própria IA "humanizar" o texto. Fui conferir do jeito mais direto: pedi ao Claude que abrisse a skill de humanizar instalada aqui e me dissesse o que ela faz.
São 474 linhas, e zero menções a marca d'água, SynthID, token, amostragem ou proveniência. O conteúdo é uma lista de tiques de escrita: ênfase indevida em relevância, gerúndio empilhado para fingir profundidade, linguagem de folheto, atribuição vaga, travessão em excesso, régua de três.
Ela é uma editora de estilo. A marca d'água não é estilo.
E há um agravante que inverte o resultado. A skill roda dentro do Claude — então cada palavra que ela reescreve é uma geração nova, que sai marcada na hora. O manual da ferramenta do GitHub avisa exatamente isso: não reescreva texto do Claude com o Claude, se o objetivo é não carimbar de novo.
O que a skill resolve, e resolve bem, é o outro problema: o texto parecer de IA. Isso importa quando quem lê é um juiz, um cliente ou um colega, com o olho e sem chave nenhuma — que é 99% dos casos reais. Só não confunda uma coisa com a outra.
Quem marca, e o relógio de dezembro
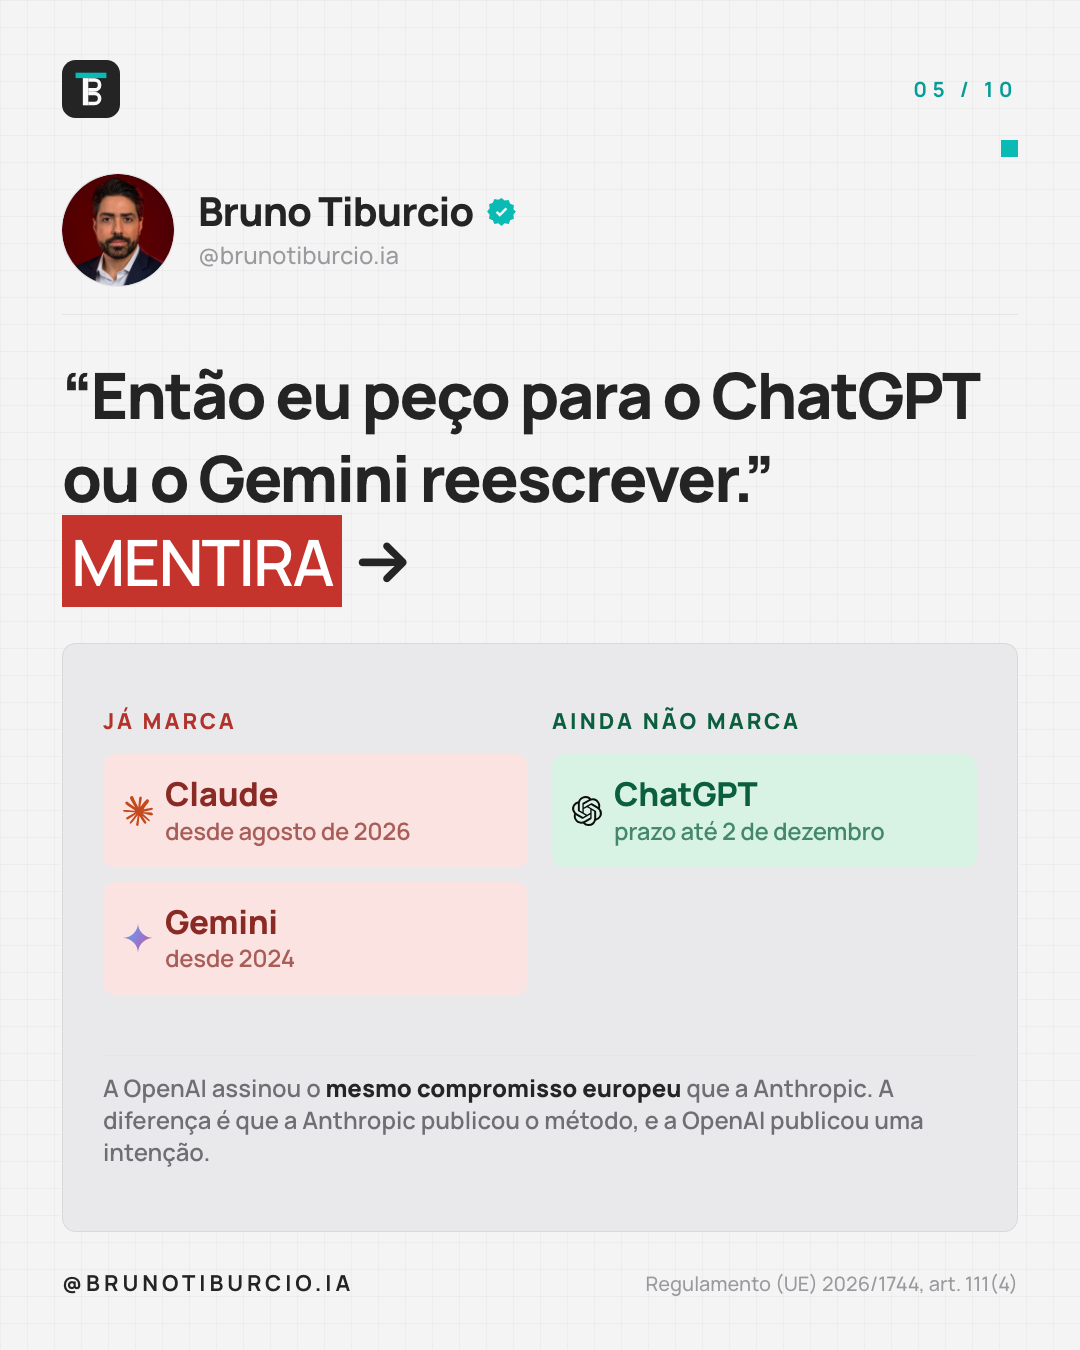
O Gemini marca texto desde 2024, via SynthID. O Claude marca desde agosto de 2026. Reescrever num deles é trocar a marca de lugar.
O ChatGPT não marca texto hoje, e isso é verificável em quatro documentos da própria OpenAI que se conferem mutuamente: a tabela oficial de sinais de proveniência tem duas linhas apenas, imagens e áudio; a ferramenta de verificação declara aceitar só imagem e áudio; a API de proveniência recebe só esses dois formatos.
Só que existe um prazo, e ele quase não circulou. O Regulamento (UE) 2026/1744, de 8 de julho de 2026, inseriu o artigo 111(4) no AI Act: provedores de sistemas que geram conteúdo sintético de áudio, imagem, vídeo ou texto, colocados no mercado antes de 2 de agosto de 2026, devem cumprir o artigo 50(2) até 2 de dezembro de 2026. O ChatGPT e a API estavam no mercado antes dessa data. A multa chega a 15 milhões de euros ou 3% do faturamento mundial.
Não há saída pelo metadado, pelo motivo que o próprio código de conduta explica: texto puro não o transporta.
O contraste que fecha o ponto: OpenAI e Anthropic assinaram a mesma Seção 1 do Código de Transparência, ao lado de Google, Meta, Microsoft e Mistral. A Anthropic publicou o método, o escopo, as limitações e uma API de detecção. A OpenAI publicou um objetivo — expandir sinais de proveniência para todas as modalidades, incluindo texto, conforme padrões e ferramentas amadureçam. Sem data e sem método.
A xAI não assinou nenhuma das duas seções, e não há esquema publicado para o Grok. Mas não assinar não isenta: o artigo 50(2) é lei, e quem fica fora do código apenas perde o porto seguro.
O modelo aberto na sua máquina
Sobra uma saída, e ela é a única que resiste ao escrutínio: um modelo de pesos abertos rodando no seu próprio computador.
Isso não é opinião. O código do Ollama, na árvore inteira, não tem uma ocorrência de watermark nem de synthid, e não carrega SDK de analytics. No llama.cpp, a única ocorrência da palavra em todo o repositório é o nome de uma métrica de monitoramento.
O argumento contrário mais forte seria o Gemma, modelo aberto do Google, que teoricamente poderia trazer o SynthID embutido. Não traz. A marcação entra por um mix-in que estende tanto a classe do Gemma quanto a do GPT-2 — o mesmo envelope serve para um modelo de 2019, o que prova que não é propriedade dos pesos. O campo de configuração da marcação vem nulo por padrão, e não aparece nos arquivos publicados de Gemma 3, Qwen3, Mistral ou gpt-oss. O relatório técnico do Gemma 3 não menciona SynthID uma vez sequer.
Os modelos chineses também não marcam fora da China. As medidas do órgão regulador de lá obrigam o prestador de serviço, e o rótulo implícito obrigatório é metadado de cabeçalho com o nome do prestador — mecanismo que não se aplica a um modelo rodando sozinho na sua máquina.
Duas ressalvas, porque sem elas isto vira propaganda:
- Não estar marcado não é ser irreconhecível. Existe atribuição estatística por estilo. É classificador probabilístico, sem chave e sem garantia, e os melhores números da literatura são em código de programação, não em prosa jurídica revisada. Mas existe.
- Você troca a marca pela qualidade. O modelo gratuito escreve pior que o modelo caro, e o manual da ferramenta do GitHub faz a pergunta que ninguém quer responder: se o plano é reescrever com um modelo mais barato de qualquer forma, por que pagar pelo caro?
A resposta honesta dessa pergunta é o método que sobra: você quer o raciocínio e a minuta do modelo bom, e aceita uma passada de reescrita depois. O próprio manual reconhece esse caso de uso, e recomenda para a reescrita um modelo local de pesos abertos, diferente do modelo de origem.
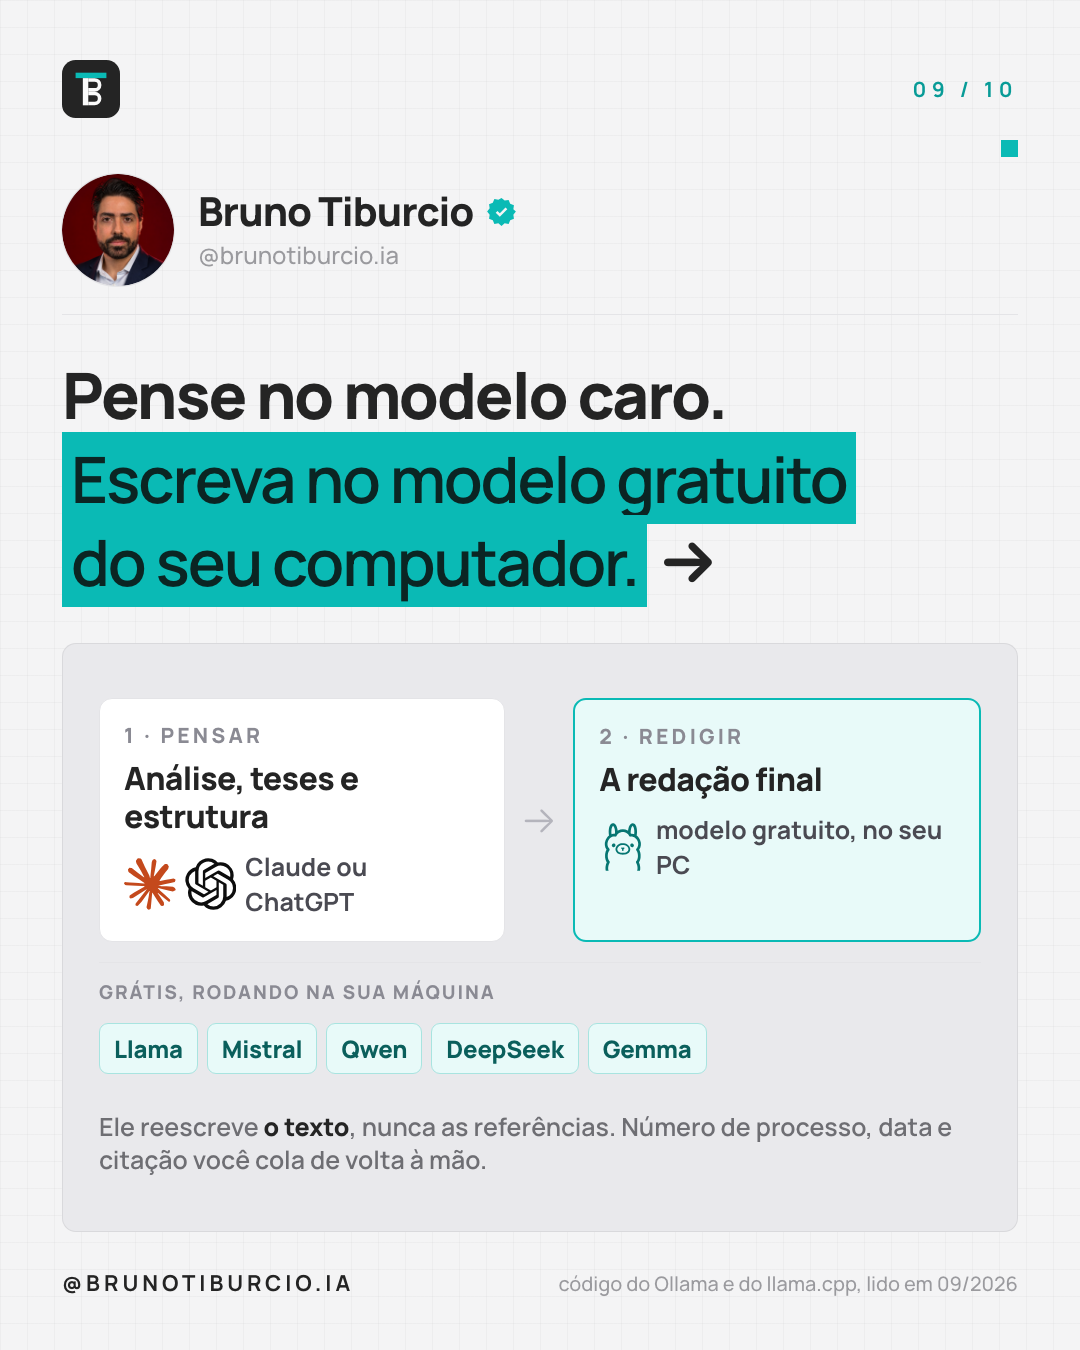
Se você for por esse caminho, uma trava é obrigatória: o modelo local reescreve o texto, nunca as referências. Número de processo, data, valor e citação você recoloca à mão e confere um a um. O modelo mais fraco é exatamente o mais propenso a corromper esses campos — e corromper referência é o único erro deste assunto que tem consequência real.
O que a marca prova, e o que ela não prova
Aqui está o ponto que desmonta boa parte do pânico, e ele vem da documentação da própria empresa que criou a marca.
Detectar a marca indica que o conteúdo pode ter passado pelo Claude, e isso, sozinho, não confirma a proveniência do texto. Não diz quem escreveu, não diz se houve revisão, não diz se o trecho marcado é uma linha ou o documento inteiro.
E a ausência também não prova nada. A marca pode não sobreviver a edição pesada, paráfrase, tradução ou mistura com outro texto, e trechos curtos podem não ter sinal confiável.
Nem achar prova, nem não achar inocenta.
Quanto a quem consegue detectar: nenhum site público lê a marca em texto. Os verificadores que devolvem porcentagem estão estimando por estilo, e erram muito — inclusive contra texto humano formal, que é exatamente o registro de uma petição. A API de detecção da Anthropic existe, em prévia fechada, e a lista de quem pode pedir acesso inclui reguladores, forças da lei, imprensa, agências de checagem, pesquisadores independentes e instituições de ensino. Não é "ninguém"; é "ainda não é qualquer um".
O que o Brasil já pune, e não é usar IA
Nenhuma norma proíbe advogado de usar inteligência artificial. A Resolução CNJ 615/2025 abre o artigo 10 com "são vedados ao Poder Judiciário" — ela regula o tribunal, não você. O advogado aparece na resolução como usuário externo, e a OAB como fiscal, com direito de acesso às avaliações de impacto algorítmico.
E o Judiciário usa. O STF minuta ementas e relatórios com IA generativa; o STJ minuta relatórios de decisões monocráticas com um sistema desenvolvido internamente. Em 2024, quase metade dos tribunais brasileiros já usava IA generativa.
O que existe, e é real, é outra coisa. Uma base independente cataloga decisões em que alguém levou aos autos julgado que não existe. Em setembro de 2026 são 2.009 casos no mundo, e 41 deles são brasileiros. Nenhum por usar IA. Todos por citação inventada.
O teto já foi testado no tribunal mais alto: em maio de 2025, na Reclamação 78.890, o STF condenou ao dobro das custas e oficiou o Conselho Federal da OAB e a seccional. Em 17 dos 41 casos brasileiros saiu ofício para a Ordem.
Nenhum tribunal brasileiro tem detector de marca d'água. Os dois sistemas que costumam ser citados como tal — o Berna, do TJGO, e o Bastião, do TJPE — medem similaridade entre processos para identificar litigância predatória, e não autoria de texto.
O que fazer com isso
Antes de tentar apagar, veja se há o que apagar. Texto que você escreveu e mandou revisar quase não marca, porque as palavras continuam suas. Código quase não marca, e as diretrizes do artigo 50 excluem código expressamente. Texto abaixo de 200 tokens não tem sinal. O que marca cheio é texto longo escrito do zero — e tradução, porque nela cada palavra é escolha do modelo.
Limpe os caracteres invisíveis, e não pela marca d'água. O ChatGPT insere um espaço estreito sem quebra no texto que gera; a própria OpenAI classifica como resíduo de treino. Ele viaja junto quando você cola. É higiene de documento, como rodar o corretor antes de protocolar, e a camada A da ferramenta faz isso em segundos.
Se for reescrever, use modelo local e proteja as referências. É o único caminho sem prazo de validade.
E confira a fonte. Toda citação, todo número de processo, toda data. Leva dois minutos por peça e resolve o problema que nenhuma reescrita resolve. Apagar a marca cuida do medo; conferir a fonte cuida do risco.
Como refutar este texto
Três pontos onde eu posso estar errado, e como você verifica:
O prazo de dezembro. A numeração "artigo 111(4)" não consta de texto consolidado oficial — o serviço de apoio do AI Act ainda serve a versão de junho de 2024, com apenas três parágrafos nesse artigo. Eu confirmei o parágrafo no ato modificativo, o Regulamento (UE) 2026/1744. Se você encontrar consolidação diferente, o prazo muda.
O teste independente é de 2024. O trabalho da ETH Zurique apresentado no ICLR 2025 concluiu que nenhum dos modelos testados estava marcado, mas testou GPT-4, Claude 3 e Gemini 1.0 Pro. Não localizei reexecução sobre as versões atuais.
Os arquivos de configuração dos modelos abertos. Li os de Gemma e Llama em espelhos públicos, porque os repositórios oficiais exigem aceite de licença. Para fechar em cem por cento, basta abrir o arquivo de um modelo já baixado na sua máquina e confirmar a ausência do campo de marcação.
O que eu não vi, eu digo que não vi. É o mínimo que se pode exigir de um texto que passou onze telas dizendo que os outros afirmaram demais.